
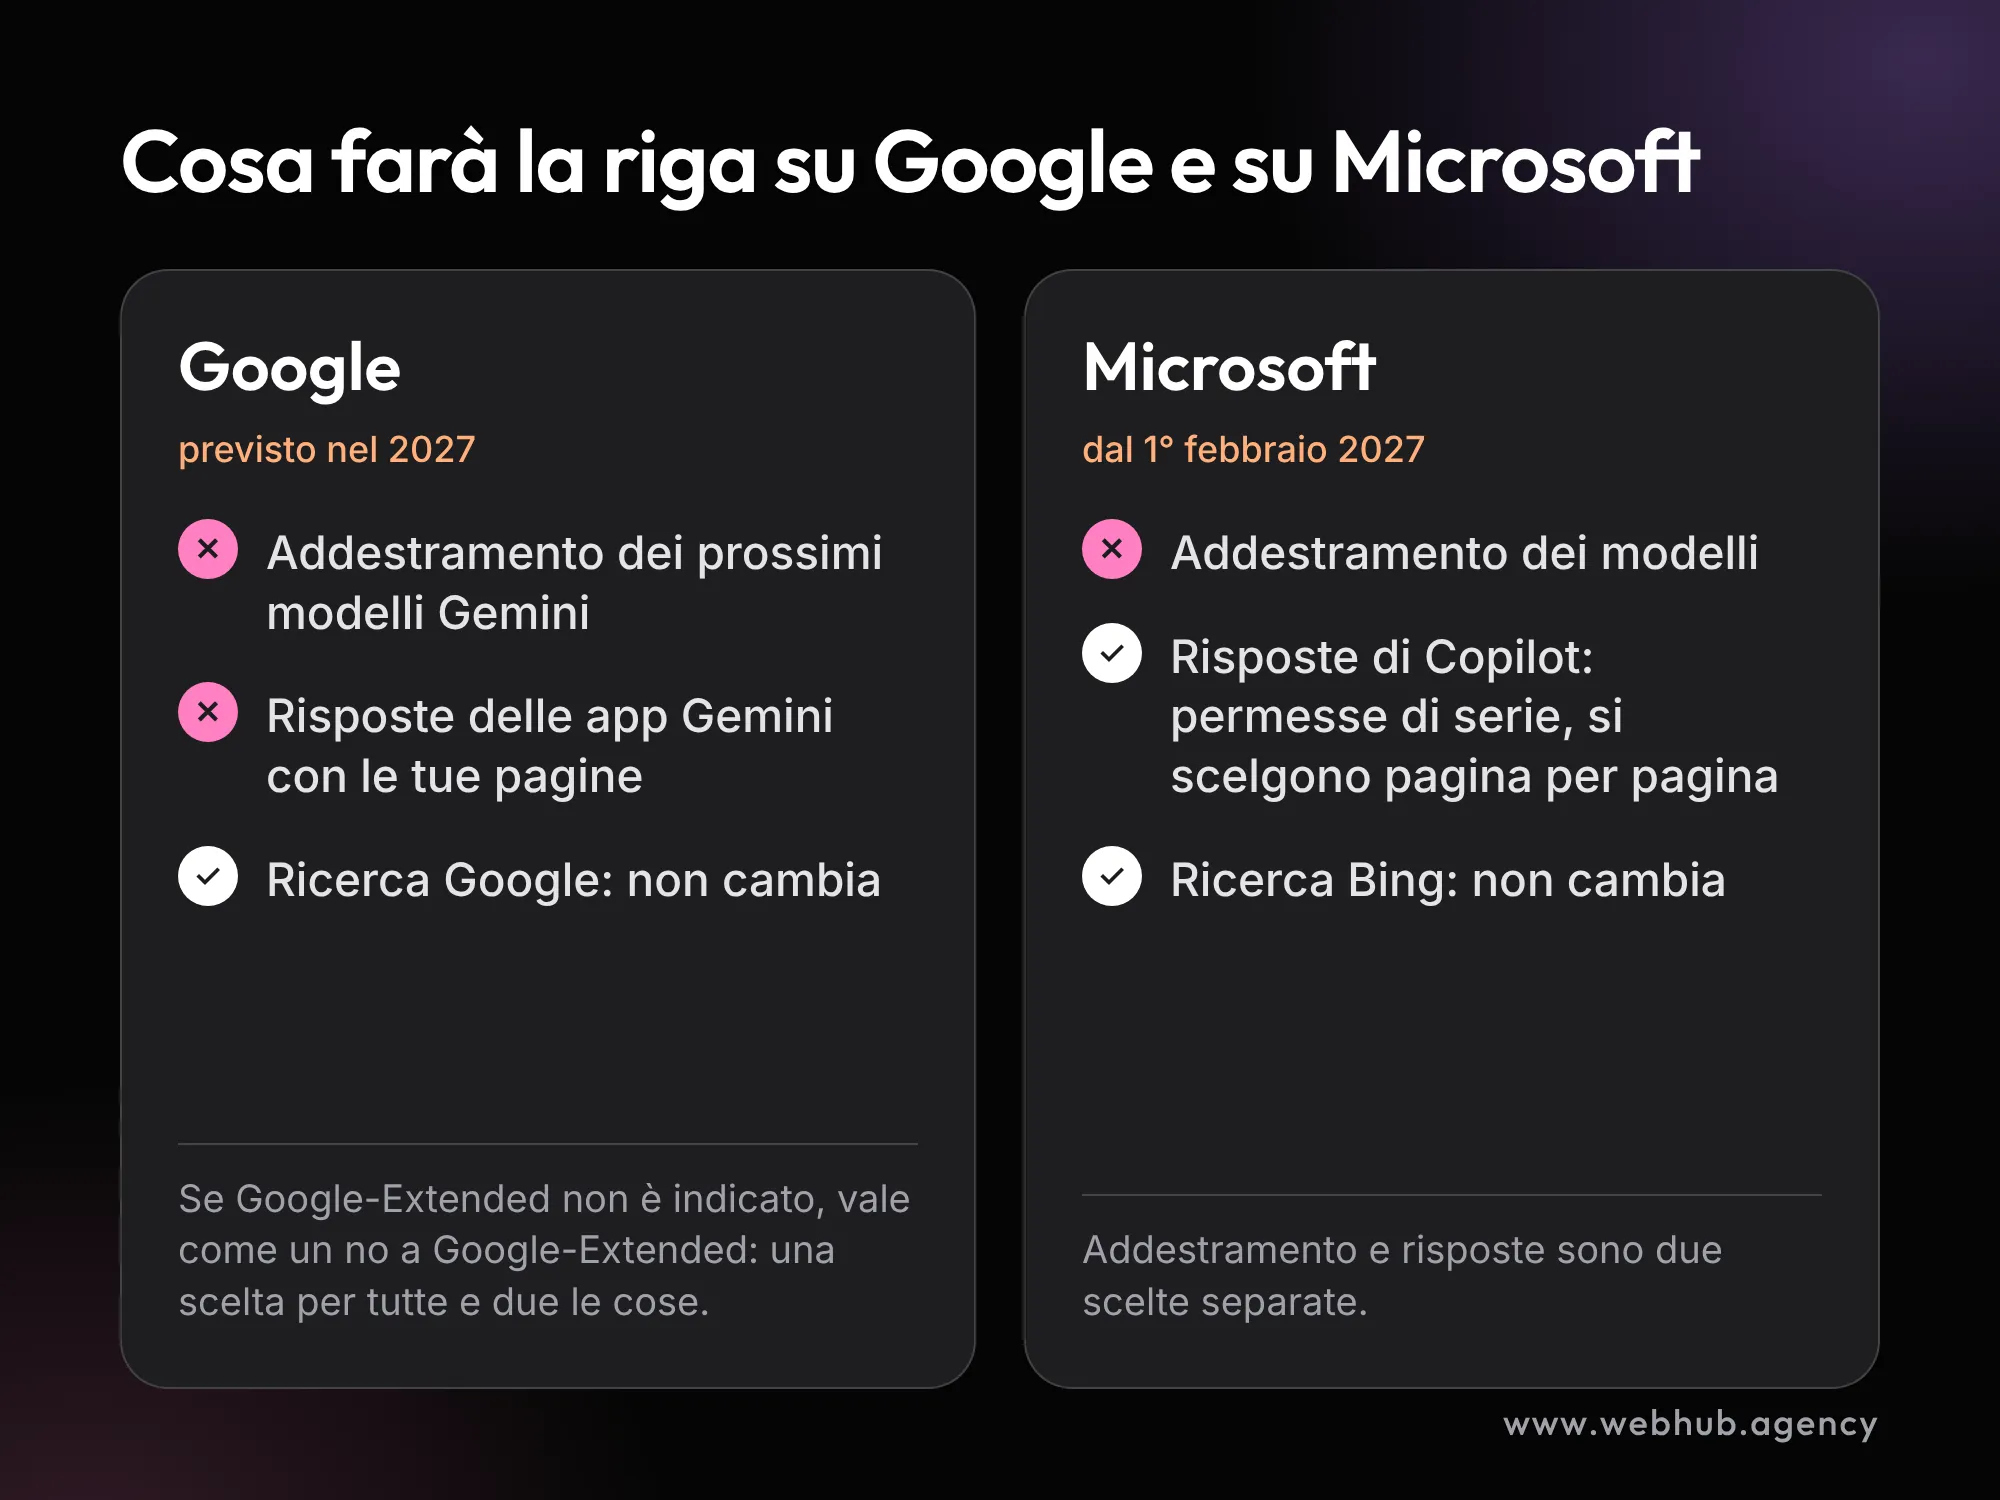
Una nuova riga del robots.txt, “User-Agent: __usage_ai-training” seguita da “Disallow”, servirà a chiedere che i contenuti del tuo sito non vengano usati per addestrare l’intelligenza artificiale generativa. Il 30 ottobre 2026 Microsoft ha annunciato che la rispetterà dal 1° febbraio 2027 e Google che intende farlo nel 2027. Oggi è solo un annuncio e la riga non cambia ancora niente. Su Microsoft riguarderà soltanto l’addestramento; su Google, se non indichi altro per Google-Extended, dovrebbe portarti fuori anche dalle risposte delle app Gemini, mentre la ricerca Google non cambia.
In questo articolo
Cosa è successo?
La proposta è una bozza pubblicata all’IETF il 30 ottobre 2026 da Kevin Kelley, di Anthropic. È un Internet-Draft individuale: l’IETF non l’ha approvato, non è uno standard e la bozza scade il 3 maggio 2027. Lo stesso giorno sono arrivati gli annunci di Google e di Microsoft.
La riga si scrive come un normale gruppo del robots.txt. Al posto del nome di un crawler va il “token” __usage_ai-training, poi Disallow per le cartelle da tenere fuori e Allow per le eccezioni. Nell’esempio della bozza tutto il sito è escluso dall’addestramento tranne la cartella /press-kit/. Altri due dettagli della bozza:
- la riga esprime una preferenza e, come scrive la bozza, non è una direttiva di scansione: i crawler possono ancora leggere le pagine;
- un gruppo “User-agent: *” non vale per il token: se nessun gruppo lo nomina, il sito non ha espresso nessuna preferenza.
Perché su Google la riga costa di più?
Google ha scritto che, quando un sito usa il token per dire no all’addestramento e non indica nulla per Google-Extended, prevede di leggerlo come un Disallow su Google-Extended. Se invece Google-Extended è indicato in modo esplicito, vale quella scelta. Google-Extended è il controllo che Google offre dal 2023 e la documentazione dei crawler dice che decide due cose insieme: l’addestramento dei prossimi modelli Gemini e il grounding, cioè l’uso delle pagine per costruire le risposte nelle app Gemini e su Vertex AI. Con una riga sola si esce da entrambi.
Sulla ricerca, la stessa pagina dice che Google-Extended non incide sulla presenza del sito in Google Search e non è un fattore di ranking.
Microsoft ha scelto un’altra strada. L’addestramento si decide con il robots.txt o pagina per pagina. Il grounding, cioè l’uso dei contenuti per aiutare a costruire le risposte generate (tra cui quelle di Copilot e di Microsoft 365), è una scelta separata, solo pagina per pagina, con un meta tag o un header. Ha tre valori: Allow, Disallow e DisallowExtended, che tiene le pagine nelle risposte dei prodotti Microsoft ma le esclude dai servizi di grounding che Microsoft fornisce ad altre aziende. Se non scrivi niente, le pagine restano utilizzabili per le risposte. Microsoft avverte che chi limita il grounding vedrà ridursi la visibilità del brand nelle esperienze AI, e che nessuna delle due scelte garantisce presenza, traffico o compensi. Le preferenze nuove valgono man mano che Microsoft scansiona le pagine.
Cosa cambia per una PMI italiana?
Chi ha un sito potrà usare una riga sola, che Google e Microsoft hanno annunciato di voler leggere, invece di scrivere un gruppo per ogni crawler e seguire le regole di ognuno.
Prima di usarla conviene decidere cosa ti interessa di più: proteggere i contenuti o farti trovare nelle risposte AI. Se vendi contenuti (corsi, guide a pagamento, testi che sono il tuo prodotto), tenerli fuori dall’addestramento può avere senso. Se il sito serve a portarti clienti, come per molte aziende di servizi e molti e-commerce, uscire dalle risposte delle app Gemini toglie un punto in cui un cliente può incontrarti.
Le risposte AI dentro la ricerca Google sono un’altra cosa: delle AI Overviews sulle ricerche di brand abbiamo scritto qui.
Google e Microsoft cominciano nel 2027, quindi c’è il tempo per decidere una cartella alla volta.
Cosa fare adesso?
Il primo controllo è sul robots.txt che hai già: a volte contiene regole che nessuno ricorda di aver messo.
- Apri il tuo robots.txt all’indirizzo tuosito.it/robots.txt e guarda se ci sono già gruppi per Google-Extended o per altri crawler di IA. Se c’è un Disallow su Google-Extended e nessuno sa chi l’ha messo, chiediti se oggi lo vuoi davvero: ti tiene già fuori dalle risposte delle app Gemini.
- Dividi il sito in cartelle. Le pagine che portano clienti, come servizi e prodotti, di solito conviene lasciarle aperte. I contenuti che vendi sono i candidati a restare fuori. La riga accetta percorsi, quindi non devi scegliere per tutto il sito.
- Lascia com’è il gruppo di Googlebot. La riga nuova e Google-Extended riguardano i modelli Gemini; Googlebot è il crawler della ricerca Google, e le regole che hai per lui non c’entrano con questa scelta.
- Se usi già i tag NoArchive o NoCache per Bing, entro il 1° marzo 2027 pubblica le preferenze nuove. Per le risposte servono la preferenza sulle pagine e, nel frattempo, quella temporanea in Bing Webmaster Tools, disponibile dal 15 dicembre 2026. Dopo il 1° marzo NoArchive e NoCache non valgono più come preferenza per addestramento e risposte.
- Non aspettarti effetti prima del 2027. Fino alle date di Google e Microsoft la riga non cambia niente, e resta una richiesta: non impedisce a un crawler di leggere le pagine.
Se non sai cosa c’è oggi nel tuo robots.txt o quali pagine ti portano contatti, possiamo guardarlo insieme. È un lavoro che rientra nel servizio SEO di WebHub. Scrivici l’indirizzo del sito e ti rispondiamo con un preventivo.
Fonti
- Supporting a shared AI training control for websites, Google Search Central Blog, John Mueller, 30 ottobre 2026
- Google’s common crawlers: Google-Extended, Google Search Central, aggiornata il 30 ottobre 2026
- Your content, your choice: clearer preferences for training and grounding, Microsoft Bing Blog, Krishna Madhavan, 30 ottobre 2026
- Machine-Readable Training Preference Signal, Internet-Draft draft-kelley-aipref-training-preference-signal-00, Kevin Kelley (Anthropic), IETF, 30 ottobre 2026


